Технический долг
Что-то написать про техдолг хотелось давно, в закладках копились статьи, цитаты и видосики (настолько, что один видос на года стал обложкой “смотреть позже” на ютубе), но все не доходили руки. И может, это к лучшему, потому что за последние лет 5 и опыта стало немного больше, и мои взгляды на эту тему немного изменились.
Цель статьи — определиться с понятиями и немного систематизировать свой опыт, связанный с техническим долгом и его устранением.
Что такое “техдолг”
Первая проблема — все определяют технический долг по-разному: сколько людей, столько и определений. Некоторые даже считают, что этот термин вообще к “технике” никакого отношения не имеет.
Идеалисты, пуристы и прочие архитекторы в составе определения могут указать, что техдолг — это намеренное, задокументированное и обоснованное решение в чистом коде, о котором извещен бизнес, и по которому есть план исправлений, а все остальное — это “cruft” (хлам/говнокод). Подобного мнения придерживается, например, Роберт Мартин. Звучит конечно классно, но, увы, очень уж нереалистично: если решение принимается из-за сжатых сроков, то код высочайшего качества производить никто не будет. Чуть более мягкий вариант описывает техдолг как последствия решений и компромиссов, когда жертвуют качеством ради скорости. Но тут подразумевается, что кто-то это решение осознанно делает и понимает все последствия.
На другом конце спектра — очень широкие определения уровня “все что не нравится разработчику” или “любое несоответствие системы оптимальному состоянию”. У них проблема в том, что их широта не позволяет нормально использовать их при обсуждении улучшений и приоритизации. Да и легко попасть во вкусовщину — одному не нравится, другому — норм, бизнесу вообще до кода дела нет, и ему совершенно неясно, а как это повлияет на пользователя, что у вас теперь форматирование будет другим. Иногда можно встретить уточнения, что техдолг — это проблема в технике (код, тесты, архитектура, инфраструктура, документация и т.п.), которая несет расходы и/или последствия.
Под вариацию “любое несоответствие системы оптимальному состоянию” попадают все баги. При этом стоит отметить что сам по себе “баг” (или дефект) — тоже довольно широкое понятие, и может включать как бизнесовые проблемы, так и технические. Так можно утверждать, что любой баг — это тоже техдолг. Или чуть менее радикально: баг становится техдолгом, если вы приняли решение его не фиксить. И если у вас политика нулевой толератности к багам, то это даже логично. Но в большинстве команд баг и техдолг — это все-таки разные вещи. Отмечу, что любые баги — это сигналы проблем разработки: плохо спроектировали, код написали тяп-ляп, плохо протестировали, требования неполные и т.п., и причиной некоторых из них может быть как раз техдолг. В отличие от техдолга, большинство багов сами по себе обычно не влияют, например, на скорость разработки.
Некоторые скажут, что технический долг вообще не про качество и связан только с бизнес-контекстом: поменялся контекст или расширилось понимание бизнеса — появляется техдолг из-за того, что код не соответствует бизнес-модели, а все остальное — мишура. В этом есть зерно истины: бизнес интересуют качества системы, и, как следствие, конечный пользователь. Если проблема не имеет видимого влияния на пользователя, пусть даже косвенного, то и обсуждать ее смысла нет.
Где-то по середине спектра Фаулер делит область на квадранты по двум осям: явность (команда может видеть проблему, а может не осознавать ее) и намеренность (техдолг может быть следствием решения/компромисса, а может возникнуть сам по себе). Похожее разделение найти можно найти у Крухтена и Макконнелла. Но это уже больше похоже на классификацию причин возникновения техдолга, чем на его определение. Определение техдолга таким образом, на мой взгляд, не дает понимания его сути.
Посмотреть еще больше вариантов определений можно, например, в этой научной статье. Там же рассматриваются различные аспекты, последствия и т.п.
Стоит отметить, что техдолг не связан со сложностью его устранения: может быть мелочь, которая мешает, но никто не может потратить 10 минут на исправление, а может быть большое говнище, которое лежит где-то в стороне и в целом не очень на что-то влияет.
Если учесть, что мы говорим о техническом долге, то изменение бизнес-контекста стоит исключить, оставим продуктовые вопросы бизнесу. При этом о техдолге имеет смысл рассуждать только если он как-то измеримо влияет на поведение или развитие системы. По факту, мы говорим про нефункциональные требования, которые в себя включают как аспекты эксплуатации системы (производительность, безопасность, надежность и т.п) так и аспекты ее эволюции (тестируемость, развитие (в т.ч. изменение кода), расширяемость и т.п.). И если проблемы с эксплуатацией — это дефекты/баги, то проблемы эволюции обычно напрямую связаны с понятием техдолга. При этом важно помнить, что нефункциональные требования должны быть конкретны и измеримы, а всякая вкусовщина (“код должно быть приятно писать”) сюда не включается. Причины возникновения не так уж важны: если помоечный код тяжело изменять, то как-то пофиг, кто какие там решения принимал 5 лет назад.
Если учесть все это, то можно ужать определение до такого: технический долг — это несоответствие системы нефункциональным требованиям, связанным с ее эволюцией. С оговоркой, что нефункциональные требования могут быть неявными (вы кстати когда настоящее ТЗ в последний раз видели?:)).
Что не является техдолгом
Чтобы закрепить определение, давайте разберемся, что не имеет смысл называть техническим долгом.
Как писал выше — баги. Некоторые баги насколько мощные, что их записывают в техдолг, но тут стоит оговориться — да, причина возникновения бага может быть техдолгом, но сам баг — это просто симптом.
MVP — минимально жизнеспособный продукт — это инструмент бизнеса, и нефункциональные требования к нему предъявляются соответствующие. Если бизнес решит, что MVP надо развивать дальше — прекрасно, начинается разработка продукта, и вот после того, как он будет введен в эксплуатацию полноценно, можно начинать говорить о техдолге. В эту же категорию попадает тестирование гипотез.
Недоделанные фичи. За это пусть у бизнеса голова болит, это не технический вопрос, а продуктовый. Если фича “не доделана” и бизнесу норм, значит, она соответствует текущим требованиям. Будет реальной проблемой для бизнеса — бизнес найдет ресурсы, чтобы ее решить.
Откровенный говнокод — однобуквенные переменные, спагетти, форматирование кто в лес, кто по дрова, функции на 200 тысяч строк и т.п. Это отсутствие базового качества. Настройте наконец сборку и/или среду разработки на форматирование и какие-то базовые вещи, чтобы даже не вспоминать про это.
Что-то, что может не нравиться (некоторым) разработчикам, но не связано с развитием системы или не мешает ему. Например, вопросы решения споров уровня табы против пробелов или какой редактор использовать. Если это не проблема, которая хоть сколько-нибудь существенно влияет на систему, то и внимание ей уделять нет смысла.
Несоответствие требованиям к эксплуатации. Условно, если у вас дырища в безопасности или прод не держит нагрузку в полтора пользователя, то это не техдолг, а проблемы, которые надо срочно решать.
Отсутствие документации. По крайней мере, само по себе. Если это документация, связанная с эксплуатацией — см. предыдущий пункт, пользовательская — вопросы к бизнесу, что ему от нее нужно. А вот если мы говорим про документацию архитектуры, высокоуровневое описание системы и т.п., то это уже относится к эволюции системы, и если система имеет высокую естественную сложность, то отсутствие такой документации влияет на скорость и качество разработки, и может быть названо техдолгом.
Прочие виды долгов. Тут что только не выделяют: процессный долг, менеджерский долг, когнитивный долг, долг намерений и т.д. Разумеется, все это тоже влияет на эволюцию системы, но это уже вопрос организации работы и развития сотрудников, и смешивать эти проблемы с техническими не стоит.
Как возникает техдолг
Подробную классификацию на эту тему можно посмотреть в научных статьях (1, 2) или у тех же Макконела и Крухтена. Но мне кажется, что слишком подробно онтологию эту вести мало кому нужно на практике, да и с учетом неустоявшегося определения тяжело будет это делать.
Опять же, обсуждать техдолг имеет смысл для того, чтобы с ним что-то сделать. И в этом плане полезно разделение, которое релевантно для принятия решений. Мне кажется тут важны два критерия: наличие договоренности с бизнесом (осознанность решения) и источник проблемы (внутренний/внешний). Наличие договоренности — это аргумент для приоритизации (и, соответственно шанс на обратную связь, работают ли договоренности). Внутренний источник проблемы — повод для улучшений в команде, процессах и прочих аспектах, а на внешний мир тяжело и часто бессмысленно воздействовать.
Осознанное решение
“Настоящий” техдолг по мнению многих: четко оценили проблему, взвесили варианты решения, осознали последствия каждого из них, вдумчиво обосновали, задокументировали и вообще все сделали по уму. Берем “долг” для решения текущих проблем, позже выплачиваем, отличный инструмент взрослых дядек-бизнесменов. Примерно в таком виде изначально метафора и зародилась. И да, это можно встретить на практике, но довольно малый процент техдолга появляется именно таким образом.
Подобные решения можно условно поделить на тактические (“исправим в следующем релизе”) и стратегические (“этот костыль пока не трогаем, скоро будет работа X, в рамках нее поправим”).
К сожалению, более частый сценарий — это попытка получить скорость ценой качества. И хотя решение осознанное, последствия редко кто проговаривает, да и на длительной дистанции если постоянно так делать, ни к чему хорошему это не приведет: все эти бестпрактисы написания качественного кода как раз и нужны для того, чтобы его легче и быстрее было менять в будущем.
Причем не всегда менеджеры требуют скорость только ради скорости. Иногда подобные решения — это просто выживание: если не успеем сделать, то бизнес завтра может перестать существовать или влететь на большие бабки. Опять же, бывают внешние факторы, с которыми ничего не поделаешь. Например, в моей практике было, что обновляется законодательство, и прям НАДО к определенному сроку (дата вступления закона в силу) успеть что-то сделать.
Но если такие авралы каждый день, то это звоночек организационных проблем. Если поощряется тяжелая работа, а не умная, и надо больше фич, а не качественный продукт, то и поведение людей, и результаты будут соответствующие. В этом плане еще раз рекомендую прочитать статью про то, как циклы положительной обратной связи способствуют деградации возможностей команды.
Организационные проблемы могут проявляться и через межкомандное взаимодействие. Например, когда надо сделать изменения в нескольких компонентах с разными владельцами и/или нужны какие-нибудь согласования, часто можно попасть в ситуацию, когда команда делает костыль, который не требует всего этого (см. Закон Конвея).
Следствие других решений
Организационные проблемы могут проявляться и через разработчиков. На изи можно нагенерить техдолга на ровном месте, потому что за это повысят или это будет хорошо смотреться в резюме. И наоборот, если стимула делать хорошо нет, то многие будут делать как проще:
Если нет времени на вдумчивую работу или это не поощряется, то будет на выходе первое решение, которое подходит под критерии выполнения задачи. Вариант “потратить еще время и упростить” может тупо не окупиться с точки зрения личной мотивации. И хорошо еще, если это осознанное решение (“я знаю, что можно лучше, но никто это не оценит”), иногда это просто путь наименьшего сопротивления. Особенно, если инициатива наказуема, и время на улучшения не выделяется — тогда и решаться будет максимальная узкая и тактическая задача.
А такие маленькие и изолированные тактические изменения — путь к смерти от тысячи порезов. Каждое изменение само по себе может быть адекватным (например, “добавим еще одно поле к объекту”), но в совокупности у вас может получиться какое-то аморфное непотребство с огромной “наносной” сложностью. А еще кучей мелких инкрементов очень легко сделать задачу не до конца. Чтобы такое предотвращать, у команды должна быть внятная стратегия, а некоторые команды даже текущие приоритеты могут озвучить с трудом. Классический пример — делаем какую-нибудь миграцию, смигрировали 80% за 20% усилий, остаток положили в бэклог, потому что бизнесу ща срочно надо другое. Так можно годами жить с чемоданом без ручки или двумя параллельно работающими системами.
Могут быть просто конченые процессы. Например, если любой ПР на рефакторинг должен быть отдельно от фичи — угадайте, как это повлияет на количество рефакторинга?
Все выше перечисленное усиливается инженерной культурой, историей и всякими “так исторически сложилось”. Если всем на все пофиг, (серьезные) проблемы не решаются годами, хреновая документация, низкое (или отсутствующее) качество тестирования, отсутствие передачи знаний — то не стоит тут многого от качества системы ожидать. Может конечно прийти новичок с горящими глазами, и ему даже что-то удастся сделать до того, как поймет, что лишний в этой культуре — он. См. теорию разбитых окон.
При этом качество кода может быть не очень высоким просто потому, что команда недостаточно опытная или нет нужной экспертизы. Команда может искренне делать как можно лучше в меру своих способностей, но со временем появляется больше опыта, команда зреет и уже вещи, которые казались нормальными раньше, воспринимаются как техдолг. Схожая ситуация может быть связана с отсутствием доменных знаний, подходящих инструментов, полноценной документации и т.п. — сделали как могли/поняли с учетом имеющегося окружения. Даже если у вас команда профессионалов, она все равно может работать фигово. Бывает, что достался проект, в котором никто ничего не понимает, а делать надо — очевидно, что шанс возникновения проблем в таком случае довольно высок.
Продолжать можно еще долго; если есть какая-то дисфункция на уровне организации, то и в систему она рано или поздно протечет.
Внешние (неконтролируемые) изменения
Иногда техдолг появляется “сам по себе”, и не является следствием каких-либо решений команды или даже компании. Просто поменялась окружающая среда и внешние обстоятельства.
Например, на уровне компании приняли какое-то глобальное решение: о переезде на другой стек технологий, об устаревании вашего текущего, какие-то глобальные архитектурные правила, переезд из собственных серверов в облако или из одного облака в другое и т.п. Все, что написано “по-старому”, автоматом становится техдолгом.
Устареть могут и зависимости — внешнее API устарело, библиотека перестала развиваться, left-pad удалили, подрядчик резко поднял цены и т.п. Например, если вы зависите от внешнего API, и сервис планирует отключить вашу версию в пользу новой, то у вас возникает техдолг, с которым нужно что-то делать, хотя никто в команде никаких решений не принимал.
Наконец, сама индустрия может двинуться вперед и неявные требования, связанные с лучшими практиками, могут быть замещены более новыми из-за обнаруженных изъянов. Например, XML был вполне себе адекватным стандартным решением для своего времени, но будет считаться техдолгом во многих местах сейчас (разумеется, не без нюансов и “зависит от задачи”).
Какие последствия влечет за собой большой техдолг
Техдолг в том или ином количестве есть везде, это нормально, но слишком большое его количество губительно для продуктивности команды и успеха продукта.
Даже само знание о термине открывает форточку манипуляций: катим в прод говнокод, объявляем “техдолгом” и “тактическим решением”, гордимся визионерством, никогда не фиксим. Повторяем несколько раз → качество летит в помойку. Например, сегодня добавили “просто еще одно поле” к объекту, потому что это “проще”, и пофиг, что оно к этой модели не имеет отношения; а через полгода лишних полей уже десяток, и отделить их — целая история. Из-за отсутствия четкого определения очень легко любую проблему или недостаток обзывать “техдолгом”, срезая углы.
Ниже скорость разработки. Качественный код — это как раз такой, который легко поддерживать и развивать, поэтому большое количество техдолга способствует существенному снижению скорости на всех этапах разработки. Код — лапша и нагромождение лишних абстракций? Разработчик будет дольше искать место для изменений. Архитектура конченая? В новом компоненте будем делать нетривиальные приседания, чтобы обойти ее ограничения (получим еще более конченную архитектуру). Деплой — 500 строк кода, написанных 5 лет назад уволившимся разрабом, который даже не шарил в девопсе? Удачи добавить туда еще один простой шаг. Как следствие — стоимость разработки увеличивается.
Больше багов. Если тяжелее сделать “правильные” изменения, то значит в среднем изменения будут с дефектами. Например, в запутанном коде легко допустить ошибку — как по незнанию, так и по непониманию. Нет автотестов и тестируем руками полтора сценария? Сегодня отвалится одно, починим, завтра отвалится другое (можно повторять по кругу).
Все нюансы, костыли и известные баги — это контекст, который надо помнить и знать. Это довольно существенная когнитивная нагрузка, которая влияет не только на текущую команду, но и мешает онбордить и обучать новых сотрудников. А некоторые закутки настолько дремучие, что все нюансы только в голове у полутора экспертов, что довольно плохо влияет на bus-factor.
Пустая трата времени. Больше багов — больше времени тратится на их сопровождение и исправление. Иногда доходит до абсурда: суммарное время на обсуждение бага и его деприоритизацию может превысить время на его исправление. Кучу времени можно спустить на ручной труд по “временному” процессу, вместо того, чтобы потратить время на его автоматизацию, хотя бы частичную. Поскольку нет четкого понимания, что такое “техдолг”, можно потратить много времени, героически борясь с “техдолгом”, который не был проблемой (например, вкусовщина в коде) или не был проблемой, стоящей внимания (например, в проекте используется фреймворк не самой новой версии).
Менее стабильный прод. Просто больше вариантов, что может пойти не так. И на разбор инцидента с восстановлением уйдет больше времени.
Продукт становится менее предсказуемым — непонятно, какие последствия повлечет собой исправление бага или добавление фичи; нет уверенности, что прод завтра не упадет; “покрасить кнопку” может занять от 5 минут до 2 недель.
Появляется страх вносить изменения: “работает — не трогай”. Кто его знает, что может отвалиться в этот раз, особенно если в предыдущие разы что-то поломалось. Иногда так можно создать больше техдолга в попытке изолировать новые изменения от существующей базы ради снижения риска. И есть несколько страшилок, когда бизнес помер от техдолга, например, про Knight Capital, которая потеряла из-за мертвого кода 450 млн. долларов.
В совокупности эти факторы бьют по морали разработчиков, причем больнее всего достается опытным. Работать с говнокодом неприятно и сложно, от конченных процессов подгорает, дежурства и ночные деплои тоже не добавляют радости. Особенно тяжело мириться с ситуациями, когда проблема очевидна, явно мешает работе и имеет решение, но не получает приоритета (иногда годами). Или если говорить о ней много раз, но от нее всегда отмахиваются.
В особо запущенных случаях большое количество техдолга и игнорирование проблем может привести к унылой инженерной культуре с выученной беспомощностью (когда даже не пытаемся исправить кучу проблем), ведром с крабами (останавливаем других) или наплевательским отношением к качеству (“баги есть, да и хуй с ними”).
И это все плюс-минус прямые последствия, без всяких упущенных возможностей/выгод бизнеса, затрат на обслуживание, имиджа компании, меньшей удовлетворенности пользователей из-за багов, большего риска увольнений, меньших возможностей для инноваций и т.п.
У последствий можно отметить много параллелей с вариантами возникновения техдолга.
Техдолг может существовать годами, и чем дольше он в коде, тем обычно тяжелее от него избавиться.
Некоторые костыли настолько эпичные, что могут иметь свое имя (например, в одной из компаний он носил фамилию придумавшего его архитектора — “костыль Иванова”).
Так что технический долг будет только расти, даже если нет никаких новых его источников.
Как бороться
Чтобы эффективно бороться с техдолгом, надо сначала понять, что это вообще такое. После этого — повысить видимость техдолга, чтобы это было не ощущение или знание в головах, а что-то осязаемое. Обнаружилась какая-то значительная проблема — стоит завести тикет, чтобы потом можно было его предметно обсудить или добавить детали. Аналогично, когда понимаем, что создаем технический долг, то лучше сразу создавать тикет на его устранение или документировать решение в каком-нибудь ADR.
Следующий шаг — оценить, с чем стоит бороться в первую очередь, т.е. приоритизировать. Тут те же проблемы, что и с приоритезацией фич: неясно, как мерить пользу (чаще всего это “прирост продуктивности”, которую никто не знает как измерять), долго оценивать точно и слишком много неявных факторов. К одной табличке с цифрами тяжело это свести, скорее всего придется полагаться на “экспертную оценку”, но можно составить чек-лист. При этом часть определения приоритета — понимание цели, чтобы было не тупо “давайте отрефакторим” или “давайте перепишем это говно”, а четкая цель: зачем именно это нужно и что изменится с точки зрения системы в целом.
Стоит отметить, что без внятного планирования бороться с техдолгом бессмысленно: если сегодня одно, а завтра другое, то и напрягаться из-за чего-то долгоиграющего смысла нет. То же касается и стратегии: если не знаете, будет ли завтра актуален какой-то микросервис, то очень тяжело обосновать хоть какой-то рефакторинг в нем.
Дальнейшее развитие событий зависит от того, насколько бизнес вовлечен в эти ваши технические штучки.
Если любую задачу надо обосновывать для бизнеса, то надо научиться продавать задачи, связанные с уменьшением техдолга. Для этого надо связать техническую пользу с пользой для бизнеса. Условно, не “у нас кодовая база по папкам плохо разбита и это плохо”, а “очень много времени тратим на поиск места, где сделать изменения, если поправим, будем делать фичи быстрее”. Некоторые советуют использовать метафору по максимуму и считать все в деньгах, но, на мой взгляд, это какая-то ерунда. Бизнес не всегда может фичи в деньгах посчитать, а аморфные технические нюансы на деньги вообще очень криво ложатся за исключением единичных случаев.
Бизнес может быть в курсе, что технарям надо не только пилить фичи и фиксить баги, но делать что-то еще, но может не вникать в детали, просто выдавая квоту на техдолг. Это может быть реализовано в нескольких вариантах:
- Выделенный спринт. Это утопия: если у вашего бизнеса нет большого бэклога с продуктовыми задачами, то скоро он загнется, а если он все-таки есть, то должно случиться что-то исключительное, чтобы прям целый спринт отдали чисто под абстрактный техдолг. Такое может быть после большого инцидента, но на регулярной основе подобное звучит очень сомнительно.
- 10-20% времени с барского плеча выделяется на техдолг. Популярная стратегия, но на практике работает хреново: то появится срочная бизнес задачка, и эта квота будет первой в очереди на вылет, то выполнение других задач растянется (ну серьезно, вы видели, чтобы все в запланированные сроки укладывалось?). Что-то в таком варианте будет двигаться, но не очень быстро.
- Как вариация предыдущего варианта — “если останется время в спринте”. Спойлер: его не останется, а если останется, то просто в следующем спринте больше фич дадут.
- “Поправим в следующем спринте” для тактического решения — кек, см. миллион мемов на эту тему. Если договоренность сработала — почет и уважение бизнес-лидерам, но на практике встречается редко, соблазн двигаться дальше (“работает же”) слишком велик.
- Выделенный человек, aka “дежурный по говну”, периодически ротировать. Проблемы будут скорее всего те же, что у вариантов 2 и 3, а еще иногда на дежурного могут навесить вдобавок деплои, on-call или техподдержку.
- “налог на фичу” — оценка задачи искусственно раздувается. Основных проблем тут две: мелкими инкрементами тяжело добиться существенного прогресса и исправить архитектуру, да и без внятной цели это будет просто случайное улучшательство в большинстве случаев.
Для всех вариантов с квотой характерно, что она может восприниматься как “подачка” технарям от бизнеса (и может быть отменена в любой момент), и очень легко дополняется представлением, что техдолг — это универсальный термин для любых технических проблем в коде. А еще квота никак не регулирует приоритет между бизнесовыми и техническими задачами, жестко фиксируя баланс между ними, хотя на практике оптимальный баланс может отличаться в обе стороны.
Наконец, если бизнес активно блокирует всю нефункциональную разработку или продажа улучшений провалилась — придется уходить в подполье. Это как “налог на фичу”, только бизнес об этом знать не будет. Правда в один момент придется реально объяснять, почему для какой-то фигни нужно несколько дней:)
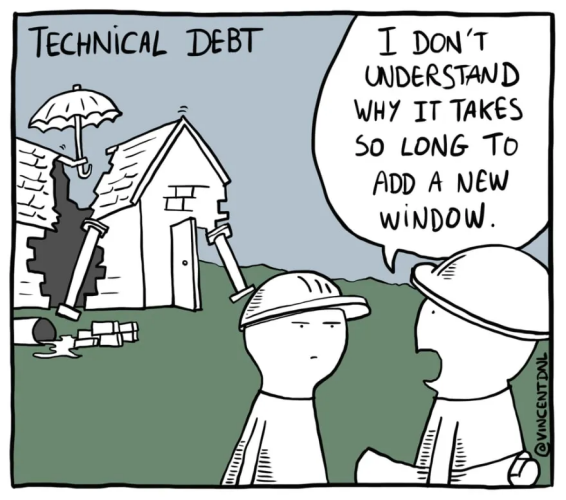
Обсуждать с бизнесом имеет смысл только крупные и средние по размерам задачи по решению техдолга. Большинство мелочевки проще исправить сразу, даже не заводя тикет. Чтобы это работало, надо работать над инженерной культурой, а именно поощрять культуру улучшений. Она работает на разных уровнях — от мелочей в коде до процессов в компании.
Простейший пример — правило бойскаута. Но с ним главное не переборщить и не уйти в перфекционизм. Не надо тешить свой ОКР или убирать техдолг ради убирания техдолга: должна быть причина и усилия должны окупиться. Например, уборка во внутреннем микросервисе, который изменяется раз в год, вряд ли себя окупит, а вот в активном коде с частыми изменениями стоит поддерживать чистоту.
Для полноты можно еще указать стратегию “не создавать техдолг”. Я надеюсь, что после раздела про пути возникновения техдолга очевидно, что это такая же хрень как и “делать все идеально”. Однако есть на просторах интернета люди, которые настолько верят в aGiLe, что думают, что он позволяет бороться с техдолгом сразу после его появления.
А нужно ли вообще бороться?
Стоит ли вообще эта борьба вложенных усилий? Кому вообще на этот техдолг не пофиг? Если в наше время Apple может быть пофиг на дизайн, а код пишет ИИ, то может, и не надо париться?
Пользователи уже надрессированы не ждать многого от программ, да и на то, что новая фича будет выпущена на пару дней быстрее, им обычно плевать.
Если бизнес, который вам платит зарплату, не интересуют все эти технические штучки для яйцеголовых, может, дать ему, что он заслуживает? Зачем делать работу, о которой не просят, иногда еще и в подпольном режиме? Премию за это вряд ли дадут.
Фича может быть удалена в следующем релизе — что толку думать о ее качестве? “Код становится легаси сразу после его написания”. Может, проще подождать, когда код пойдет на выброс? Или ИИ станет еще лучше и отрефакторит нормально?
А пресловутое легаси? Для кого-то это говнокод, но по факту — это колоссальный массив накопленного опыта, проверенный на практике и адаптированный к конкретным обстоятельствам бизнеса. Работает — не трогай!
Тудушки могут жить в коде годами, бэклог может быть такой пухлый, что разгребать его — отдельная история, и продолжать расти. И все как-то живут.
Все это рассуждения имеют право на жизнь. Повторюсь, что надо трезво оценивать пользу от решения конкретной проблемы и мужественно забивать на неважное. Если какая-то проблема не мешает — то и фиг с ней. Или, если она изолирована и не влияет на другие вещи, а меняется редко — то тоже можно не трогать. Можно вообще ничего не делать, если уверены, что код пойдет на выброс. Главное — не попасть в ловушку “нет ничего более постоянного, чем временное”.
Не надо стремиться к полному отсутствию техдолга: это не стоит усилий. Немного техдолга неизбежно накопится — в идеальном мире никто не живет. Даже с большим числом ресурсов некоторые проблемы не стоят времени, потраченного на их решение.
Итого
Техдолг — это слабо формализованное понятие, метафора, которая может быть полезна в разговорах, связанных с планированием. Возникновение техдолга практически неизбежно, но здоровые процессы существенно снижают вероятность его появления. Вдумчивое устранение техдолга положительно влияет на эволюцию системы, но бороться с техдолгом ради борьбы с техдолгом не стоит. Иногда неидеальное по каким-то характеристикам решение может быть вполне оптимальным для текущих обстоятельств.
Мысли про ИИ-кодинг
Так получилось, что кроме Codex, попробовал недавно еще немного этого вашего ИИ. Удачное время, чтобы сравнить инструменты и немного скучковать мысли для разгрузки головы. А заодно забыть об этой теме на время, так как она порядком задолбала.
Claude Code
Для первых шагов выбрал ту же задачу, что и для Codex. Когда делал ее в прошлый раз, в голову в фоновом режиме приходили мысли, а заодно и вариант решения получше, так что сформулировал задачу по-другому. Я снова принципиально ударился в крайность и ни строчки кода не написал самостоятельно.
И на работе, и в комментах к заметке про Codex вполне по делу насовали про skill issue. Claude Code по умолчанию “подталкивает” к текущему правильному подходу и сессия начинается с режима планирования. За счет этого я уже и контекста побольше навалил в начальном запросе и быстро смог отбросить плохие варианты и неверные предположения агента.
Однако сам процесс занял гораздо больше времени, чем я ожидал: примерно 2,5 дня в фоновом режиме, когда в перерывах между задачами разрешал агенту выполнить команду или немного смотрел код и говорил, что надо исправить. Причем иногда доходило до абсурда — один раз агенту понадобилось несколько минут, чтобы сделать уже одобренное однострочное изменение.
Качество кода на выходе — уже вполне достойное, но все равно надо внимательно ревьюить. Даже получилось что-то, что вмержили. Отдельно отмечу, что сгенерированные сообщения к коммитам слишком многословные.
С точки зрения UX — хорошо, что заточено все под агентскую разработку, но GUI весьма лагучий: пару раз текст сообщения агента пропадал при переключении между вкладками; несколько раз было, что чат внезапно прерывался без всяких сообщений и приходилось “пинговать” агента, чтобы продолжить.
А еще сам про себя Claude отвечает плохо: он не смог мне сказать, как его поставить без curl | sh, есть ли у него десктопный клиент и т.п.
Одобрять команды утомляет; Codex хотя бы предлагал вариант одобрения категории команд по префиксу, а тут надо в настроечный JSON лезть ради этого.
В общем, довольно много мелочевки, которая вызывала недоумение.
Как-то не очень это ваше программирование “решено”, если подобные баги в инструменте для ежедневного использования всплывают.
Конкретно на выбранной задаче я не почувствовал, что потраченная энергия и усилия стоили результата. Казалось, что у меня получилось бы лучше, если я сделал все сам.
Впоследствии, уже на более большой выборке решенных задач, я немного поменял мнение: есть задачи, которые я не очень-то хочу решать, и вместо борьбы с собственной мотивацией можно их спихнуть на агента.
Однако пока мне тяжело сказать, что таких задач много.
Да и качество очень плавающее — то какая-то магия и все отлично, то застрянет на какой-то элементарщине.
Вдобавок, несколько коллег поделились, что у них Claude мог игнорировать свои же настройки из .claude.
Copilot
В мире JS была очередная мажорная уязвимость в пакете, от которого куча других зависит. Были задеты и пара моих реп с GitHub Actions. Один action лежал просто так, более чем уверен, что его никто не использует (писал его для одной из прошлых работ). Но поскольку уязвимость серьезная, алерт пришел на почту — dependabot я этой репе давно отключил, потому что задолбал неимоверно.


Я решил чисто на рандоме попробовать дать задачу Copilot, благо это можно было сделать лежа на диване с планшета — из вкладки репозитория с агентами.
Внезапно, Copilot справился.
Описание PR — шляпа, но зато можно все уязвимости поправить в одном PR и не ждать пока в Dependabot сделают группировку (ладно, они это уже сделали, но узнал я об этом только когда эту заметку писал — настраивать мне все равно будет лень).
Воодушевленный успехом, попросил агента написать тесты — не с первого раза, но получилось правдоподобно. Я поревьюил наискосок — хуже не будет, но более чем уверен, что люди с бо́льшим опытом в экосистеме JS легко там найдут проблемы.
Позже я повторил успех с обновлением зависимостей для другого action, тоже получилось неплохо. Когда проверял результаты, заметил, что выдается предупреждение об устаревшей версии node. Отлично, работа для ИИ!
И тут случился первый обсер: после обновления action стал падать. Ошибка тупейшая: в Actions можно использовать node20 (устаревший) и node24 (новый), а опции node22 (как написал Copilot) — нет, ее пропустили. Пришлось давать еще одну задачу на обновление. Move fast and break things! Получается, что ИИ, имея полный доступ к репозиторию, контексту, документации, и обученный на датасете из очень похожих примеров, не справился с элементарной задачей во флагманском продукте той же компании в самой популярной экосистеме. Каждый бит информации по этой задаче находится под контролем GitHub. При таком раскладе так налажать — это надо уметь.
Дальше пошло под откос. В проекте со Scala и браузерными тестами обновление не задалось, потому что тесты были не очень стабильными. Агент ходил по кругу и провалился в какие-то совсем непонятные дебри, попутно генерируя треш в описании PR. Доделывал в итоге сам.
Но пик тупости случился, когда я попросил, казалось бы, элементарную вещь — добавить тег к коммиту. Агент потратил 18,5 минут, пока у него не кончилась память. Уже на ранних этапах “размышлений” агент понял, что у него нет прав доступа. Он попробовал несколько обходных путей, даже через браузер что-то сделать, но везде получал отлуп. В процессе размышлений он даже вывел свой токен просто текстом (сесурно, однако!), а потом еще и раскопал и вывел креды для раннера.
В общем, не получилось пока кодить чисто в браузерном чате, эх:(
ИИ для сопутствующих задач
Не стоит забывать, что все это — тупо казино.
Отладка и исправление багов — звучит привлекательно, но результаты рандомные: от “вау, как я сам до этого не додумался” до “че за херь я сейчас прочитал?”. Очень плохо работает для нестабильных сценариев и гейзенбагов — ИИ понимает их плохо, и легко скатывается в какое-то непонятное направление, тратя кучу ресурсов впустую. Туда же идет и исправление нестабильных тестов — результаты будут очень правдоподобными, но совершенно бесполезными.
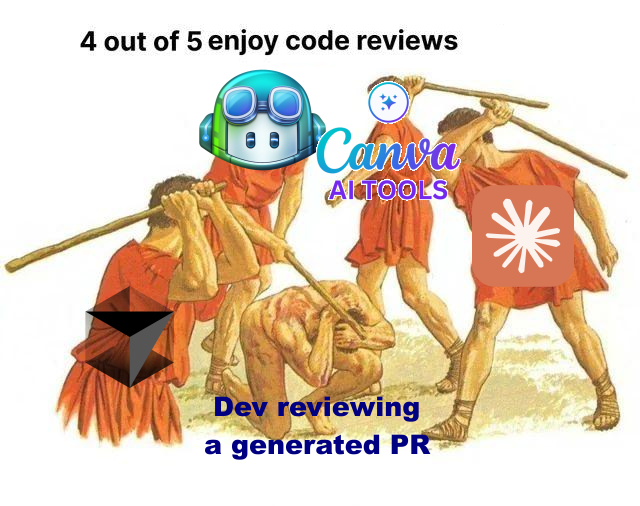
Написание тестов — для галочки сойдет, но про сценарии надо думать самому. Кодинг тут вряд ли узкое место. Читать/ревьюить сгенерированные простыни — ну, такое :/
Одноразовые скрипты для производства результата — отличная ниша, уже не раз писал об этом, повторяться не буду. Туда же идут инструменты, особенно для личного пользования — можно будет переписать с нуля при новых требованиях.
Доверять “общие задачи” — все еще сомнительно (и немного стремно, если почитать истории про OpenClaw). Недавно мне тут спам с рекламой ИИ-канала в комменты пришел: “Не нашел в описании админа канала поэтому пишу сюда”. Для справки: чтобы найти “админа канала”, нужно открыть описание, кликнуть по единственной ссылке там, попасть на этот сайт, кликнуть на Где я? и там уже будет тележный контакт (и это если не считать, что каналам можно писать в личку). 3 клика. Я дал задачу ChatGPT, Claude, Gemini и вкладке гугла с ИИ (которая тоже Gemini, но как будто немного другая) — без проблем справился только Claude. Гугловые инструменты выдали полную ерунду и неправильный ответ. ChatGPT на одном аккаунте даже в режиме глубокого исследования говорил, что не может это сделать, а потом еще и газлайтил, что в HTML-страничке канала нет никаких ссылок на сайт. С другого аккаунта худо-бедно со второго раза он смог-таки найти что нужно.
ИИ-презентации, документы и прочий текст — если насрать на результат, то сомнительно, но окей. Многие говорят, что пишут на себя Performance Review, а еще нейтрально-вежливые отзывы на коллег. Текст объявления о моем повышении был написан нейронкой — и ни один из менеджеров в цепочке его не читал. Написана там лабуда — одно достижение потеряно, другое переврано и т.п. А ИИ-сгенерированный видеоролик с презентацией итогов года, который показывают на синхронном созвоне — отдельный сорт кринжа.
ИИ для выполнения менеджерских задач… Скажем так, довольно много я поработал с менеджерами, которые могут на изи продолбать и забыть важную задачу или не суметь прочитать сообщение. Если не можешь организовать свою работу на достойном уровне без нейронок, то нейронки в этом тебе не помогут. Касается любых профессий.
Как правильно?
Ну ладно, может это я просто не умею нейронки готовить и у меня все еще skill issue? Давайте посмотрим видео от вроде как уважаемого автора курсов про то, как на практике использовать последние достижения техники агентной разработки. В ИИ-чатике на работе порекомендовали, некоторые коллеги позитивно отзывались. Рекомендую сначала посмотреть и составить собственное мнение, прежде чем читать мое.
Мои мысли про видос
Это просто пиздец какой-то.
Проект с одним пользователем, который запускается локально — уже тут можно было закрыть, никаким “real-world example” тут и не пахнет.
Чел первые полчаса голосом наговаривает задачу и болтает с планировщиком о какой-то мелочевке, обсасывая детали. Какой-то странный концепт, отличающийся одним полем, требует мелкого фикса на морде (на беке почти ничего править не надо). В итоге создана куча текста, PRD, и агенты погоняют агентами в докере чтобы сделать фичу.
Докладчик бахвалится пресловутой единой терминологией из DDD, которую он хранит в .md и которую в том числе читают агенты.
Первый коммит — как раз обновление терминологии.
Однако далее в видео он не хочет видеть только что введенный термин в пользовательском интерфейсе (sic!).
Кроме кода, агенты еще нагенерировали и план тестирования. Проходить его, разумеется, будет человек. Докладчик даже не предпринял попытки его изменить или придумать свой сценарий. Надеюсь, что план тестирования хотя бы другой агент генерировал, а не тот же, что и кодил…
Только на этапе тестирования чувак начинает осознавать, что вместо двух концептов, отличающихся одним полем, можно оставить один концепт с дополнительным полем. И это было в плане. Он его не читал. Он мог бы пофиксить эту проблему на стадии плана, если бы хоть немного вникал в суть работы. Но вместо этого он болтал о какой-то ерунде. Чувак открывает для себя, что подход spec-to-code не работает (вау, наверно и водопад — это хрень:)).
Вообще, часть созданных тикетов были про вещи, про которые никто не подумал на этапе проектирования. Если бы чел кодил и тестировал в процессе, то это сразу бы всплыло. Хотя как будто код даже агенты не тестировали. Но ничего — чувак закрыл QA-план, не пройдя его до конца. Одни проблемы от этого тестирования:))
Тем временем было создано 15 коммитов, и в каждом — простыня-описание, которую никто никогда не будет читать. После итерации исправлений чел пропустил “скучную” часть, где он все тестит еще раз и репортит баги. Сказал, что хочет показать одну вещь, и там у него была видимая проблема со скоростью создания пары файликов на диске.
Код докладчик не показал, но сказал при этом, что иногда смотрит интерфейсы. Что ж, я нашел код — вот, можете оценить. Видно, что коммитов меньше 15, но ладно, может он сквошнул, а не тупо в помойку выкинул лишнее. Изменено 43 файла, но почти везде тупо прокидывается 1 флаг или одно поле и сделан попутный рефакторинг. Добавлена одна модалка. На бэке есть несколько изменений, которые выглядели странно, потому что эта логика уже должна была существовать в других местах (если судить по началу видео).
Безусловно, впечатляет, что на все про все у докладчика ушло примерно 3,5 часа. Жалко только, что соотношение сигнал-шум очень фиговое. И как вы думаете, насколько адекватно спроектирован код, в котором для добавления 1 флага нужно 7 тикетов, 14 коммитов, 43 измененных файла и накопипащенная логика?
Натурально анекдот про изменение цвета кнопки в бигтехе за 5 месяцев. 10x инженер, но с бюрократическим нюансом:) Если так в будущем должна выглядеть разработка — я, пожалуй, пока обожду, спасибо.
Фокус и продуктивность
Некоторые активные ИИ-адепты провозглашают, что прям писать код руками скоро будет не нужно — правдоподобно, что так можно делать, но будет ли это эффективно — сомневаюсь. Если весь ваш бизнес можно навайбкодить — какая у него ценность? Если у вас нейронки автоматизируют рутину, а вы весь такой только за архитектуру и высокоуровневые решения — то кто таких решений напринимал архитектурных, что этой рутины столько много? И откуда будут браться понимание, экспертиза и адекватные абстракции?
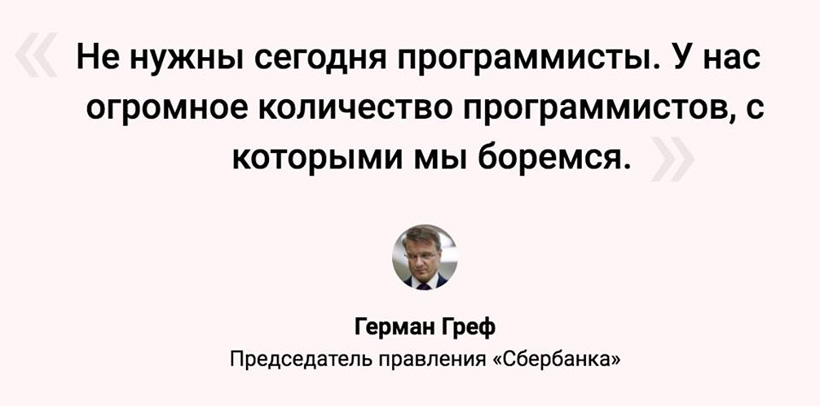
Хайп ведет к тому, что и сверху начинают требовать “быстрее” (почитай еще этих иишных линкендиновских постов, да нагенерируй слопа), люди начинают “бежать еще быстрее” и превращаться в оркестраторов агентов, чтобы “успеть”. Понимание и осознания меняются на скорость. А качество и заложение фундамента на будущее идут в известное место.
Я в один из дней осознал, что жонглирую своим вниманием, переключаясь между тремя задачами с очень низким квантом внимания (одну из задач “делал” агент). Везде получалось херово. Состояние потока — не шутка, в тик-ток режиме и результаты соответствующие.
Я пробовал слушать (не очень важную) встречу и уделять внимание агенту — получалась полная ерунда. При этом у меня есть опыт еще с самого начала удаленки — кодить рутину (или монотонно рефакторить) и слушать могу, ревьюить простенький код и слушать — тоже, но хуже. А вот с агентом — нет, слишком много внимания ему нужно.
Я пока видел несколько научных исследований, где профит от использования ИИ в кодинге был либо отрицательным, либо сомнительным (например, 1 или 2), но вот про повышение продуктивности мне ничего не попадалось (скиньте, если знаете, пожалуйста). По ощущениям, прироста производительности можно достичь, но очень вряд ли, что кратного. Некоторые вещи может и покроют большим контекстом, но у этого подхода есть предел. И не забывайте, что повышение продуктивности не обязательно будет означать, что вы будете меньше работать; скорее наоборот — будут больше требовать.
Устраивается секретарша на работу. Директор ее спрашивает:
— Какая у вас скорость печати?
— 1000 знаков в минуту!
— Так много???
— Правда такая ерунда получается…
ИИ — это автомобиль
Да-да, любая аналогия ложна и все такое, но все равно вброшу.
Автомобиль — это прогресс, он быстрее пешего перемещения или “классического” транспорта вроде телеги с лошадью. Однако в космос на нем не полетишь, море не переплывешь, а для эффективного использования нужны хорошие дороги.
Первыми авто было тяжело управлять, но потом с развитием технологий все стало проще. Однако после периода активного развития технологий происходят уже тупо инкрементальные изменения.
В соседнюю комнату на автомобиле не поедешь, в магазин у дома — тоже. Пешком ходить приятнее и полезнее, да и часть пути все равно придется пройти. Город только для машин — это тупо и неудобно, город должен быть для людей. В некоторых городах не работает интернет с картами, и надо хорошо его знать, чтобы понимать, как ехать до места назначения.
Итого
В целом, прогресс не стоит на месте и есть пласт задач, которые можно делегировать нейронке. Однако, как и любой инструмент, надо использовать с умом и понимать, когда это имеет смысл, а когда — нет. Я собственными глазами наблюдал, как сеньоры с сединой пытались решить задачу в лоб ИИшкой, когда стоило бы написать скрипт (при этом скрипт можно было бы даже тупой нейронкой нагенерировать). Ну и относительно нейтральные челики уже говорят, что мозги потихоньку атрофируются.
Если более конкретно про инструменты, то в существенном количестве задач я чувствовал себя продуктивно с Claude Code — по крайней мере, под него можно подстроиться и использовать как помощника. Codex использовать не вижу смысла, Gemini и Copilot — дауны, но последнему можно дать самые тупые, спинномозговые задачи уровня dependabot напрямую со странички репозитория в браузере.
Хайпа слишком много, у многих С-level явный синдром FOMO с соответствующими последствиями, который усугубляется “советчиком”-жополизом (“вы абсолютно правы!”). Ускорение присутствует, но и нюансы тоже есть — короткая обратная связь не гарантирует качество, и понимание приносится в жертву. При этом польза чувствуется, но надо вдвойне следить за своей способностью к критическому мышлению, чтобы не попасться в ловушку одобрения и разжижения мозгов.
Помните, что азартные игры вызывают зависимость. И да, казино всегда выигрывает.
Эксперимент с Codex
Попробовал на днях Codex — а то чё как лох, уже никто сам код не пишет, все только роем агентов погоняют… Codex выбрал из-за того, что это невероятно революционная, новая модель, которая уже открывает эпоху сингулярности, согласно некоторым авторам, да и вообще, это стандарт индустрии.
/s Ладно, ладно, на работе очень настаивали, а у Codex была акция на пробный период.
Я хотел было попробовать как белый человек через IntelliJ AI Chat (Core-фича, между прочим!), но там меня сначала регион заставили проставить, а потом еще и данные карты попросили — нет, спасибо. Пришлось скачать официальное приложение Codex. Использовал модель по умолчанию — ChatGPT 5.3 Medium.
Постановка задачи
На свежем клоне исходников Gradle дал в качестве задачи исправить этот тикет — без мудреных промптов, но с подсказкой по поводу того, откуда начинать. Суть задачи довольно простая: есть зависимости дистрибутива в отдельном файле, надо написать билд-логику по генерации файла лицензии, в котором приведены лицензии всех компонентов в поставке, и проверки его актуальности. Ссылку на файл дал, пример файла с лицензиями в репозитории есть (его просто 1000 лет никто не обновлял), в дебри кода лезть не надо (контекста, соответственно, кот наплакал — преобразовать один файл, запросить данных чуток, да и встроить в существующие проверки).
Первый блин комом
Почти сразу Codex понял, что описание тикета устарело — файл, на который он ссылался, уже удален. Я параллельно сам посмотрел — все действительно так, но это не сильно что-то поменяло бы: там был мертвый код, а файл лицензии, возможно, обновляли руками. Но подобная археология — минус вайб, так что глубже копать не стал.
Codex эта проблема не остановила. Он накодил проверку, что все зависимости в реальном дистрибутиве соответствуют тому, что объявлено в файле с их списком. Круто конечно, но это вообще не то, что я просил и с тикетом не особо связано. Код при этом был так себе, и, например, не был совместим с фичей Configuration Cache, о чем сам Gradle очень активно жалуется (этот момент Codex прочитал из вывода и мне написал).
Пробуем все-таки решить задачу
Я сказал Codex, что это не то, и дал более подробные инструкции. Он понаписал кода, но на выходе все равно получилась какая-то хрень, которая хоть и обновляла файл лицензии, но совершенно не в том формате. Я указал на это, Codex поправил, и на поверхностный взгляд теперь было “похоже на правду”.
Я решил посмотреть, а что в итоговом файле с лицензиями и заметил там зависимость, которой нет ни в дистрибутиве, ни в объявлениях. Спросил Codex — он сам проверил граф зависимостей и обновил код. Стало лучше, но не намного. В коде были видны огрызки от старых итераций.
Порефакторим
Попросил перенести код из билд-скрипта в плагин и перепроверить работу — Codex справился. Потом попросил обеспечить совместимость с Configuration Cache — попыхтел, че-то поменял, но в итоге тоже справился, даже доказательства предоставил. Читать новый код я, конечно, не стал:)
Наконец, попросил удалить неактуальный код. Вот тут Codex провалился — очевидный мусор не удалил. На мой вопрос про это Codex ответил, что он нужен для сохранения обратной совместимости. С форматом одной из предыдущих итераций, который он сам выдумал, и про который я еще тогда сказал, что это фуфло. После просьбы нерелевантный код он все-таки удалил.
Окей, проверяем результаты
Проверил файл с лицензиями еще раз — и почти сразу в глаза бросается ошибка: неправильная лицензия у BouncyCastle. О_о Но почему? Ведь код читает POM для зависимости из Maven Central, а там явно указана лицензия. Я указал на эту проблему Codex, даже ссылку на POM дал… И он просто впилил костыль — тупо сделал особый случай конкретно для этой зависимости.
Вообще, захардкоженных записей было подозрительно много, и я попросил их все убрать и явно перечислить все зависимости, для которых не нашлись лицензии. Codex вывел довольно длинный список, по дороге немного подавившись зависимостью от jQuery (в HTML-отчетах используется). Я взял первую попавшуюся зависимость оттуда, проверил POM — разумеется, в нем была объявлена лицензия :/ Попросил Codex поправить, ткнув носом — что-то он там поменял, но список был все еще длинный.
Взял еще одну зависимость наугад — ладно, теперь в ее POM не было лицензии. Спросил Codex — он сам додумался, что лицензия в родительском POM зарыта. После исправления этого косяка список сократился до 3 пунктов: jQuery, native-platform (которая тоже Gradle разрабатывается) и plexus. Первая зависимость — из мира JS, там POM и не будет, вторая — из нашей репы, да и лицензия там может быть криво прописана, а с третьей проблема была в том, что поменялись координаты (группа стала другая).
С поддержкой смены координат Codex не справился — пыхтел-пыхтел и в итоге тупо поменял координаты в объявлении зависимостей. Потребовалось еще два промпта, чтобы откатить его неработающие изменения и почистить мусор.
Соответственно, на оставшиеся две зависимости просто попросил добавить специальную обработку.
Но и после этого результат оставлял желать лучшего. Я попросил Codex перепроверить, что файл с лицензиями точно-точно содержит все зависимости и что валидация не пройдет, если будет добавлена новая зависимость в дистрибутив без изменения файла с лицензией. Codex нашел какой-то баг, начал его править… и тут у меня кончились токены: я сжег недельный бесплатный лимит.
Немного про UX
Когда я в первый раз попробовал запушить код, то приложение не справилось — не смогло спросить у меня кодовую фразу для ssh-ключа :/
Единственный вариант, который я нашел, чтобы посмотреть все изменения в ветке, чтобы их поревьюить — это запушить все и посмотреть разницу на GitHub. Хотя тут понять можно — негоже вайбкодеру код читать.
В общем, в нормальной среде разработки это может и норм работает, но в самом приложении разрабатывать — это какая-то шляпа, ничего толком не сделаешь: знай себе пиши промпты да пушай в git.
Итого
Результат можно посмотреть тут. Вроде как “работает” и выглядит правдоподобно, но есть проблемы: в выходном файле — дубликаты лицензий и левые лицензии которые уже не нужны, в коде так вообще куча стремных паттернов. Это не тот код, который я готов вмержить, даже с прицелом на последующий рефакторинг. Для одноразовой задачи одна из итераций сошла бы с доработками, но с таким и обычный чат справляется, без “агентства”.
По сравнению с прошлым опытом как будто стало лучше — меньше какой-то откровенной тупки и результаты хотя бы компилируются. Однако нянчится все равно нужно слишком много, да и фундаментальные проблемы как будто те же самые.
Во время сессии тяжело было сфокусироваться — долго ждешь результата, высокое время отклика со всеми вытекающими. Коллеги рекомендовали делать в фоне — но мне кажется, что тогда куча мыслетоплива сожжется на переключение контекста.
Наконец, результаты надо как-то проверять. Однако для этого надо наработать какой-то опыт и углубиться в проблему. Обычно это случается, когда собственно делаешь задачу.
Так что да, вроде стало лучше, но я все еще скептически настроен насчет агентного кодинга как основного способа разработки.
Образование и нейронки
Когда ChatGPT только появился, почти сразу начались обсуждения по поводу его использования в образовании (в основном со стороны студентов). А 2,5 года назад так вообще был защищен диплом, почти полностью написанный ChatGPT. Но на мой взгляд, использование нейронок, чтобы сдать какую-то работу — это не новая проблема, а скорее просто еще один фактор, который подсвечивает старые. Ну и делает все еще проще для студентов.
Ниже я выплесну свои мысли по поводу текущих проблем, в которых нейронки мало что поменяют (на основе личного опыта преподавания), расскажу о своем опыте с режимом обучения ChatGPT и поделюсь идеей учебной задачи с использованием нейронок.
Это не новая проблема
Мотивация
Если студент не хочет учиться и/или ему не интересен предмет, то насильно мил не будешь. Если студенту нужна оценка, а не знания/навыки, то и получит он скорее всего только оценку. Студент будет использовать любые средства слиться с любого задания, если ему лень, неинтересен предмет, он считает предмет не нужным, ему нужно работать, и т.д. и т.п. Избежит ли он работы с помощью нейронки или другими средствами — вообще не важно, конечный результат примерно одинаковый.
Усугубляется все это тем, что на предыдущих этапах обучения все было так же. Совершенно нормально, что студент технического вуза на третьем курсе может не знать, что такое логарифм, производная, предел. Но страшнее даже не это — студенты не хотят это узнавать. Зачем? Они все равно получат свой диплом с минимумом усилий. Однажды я поставил во второй раз двойку студентке, которая не ответила на тот же вопрос, за который получила предыдущий неуд. Более того, некоторые студенты даже не умеют искать материал — процентов 20-30 студентов я мог завалить вопросом “какого цвета учебник?”.
С точки зрения препода в таких условиях надрываться, чтобы студент сделал все сам, довольно бессмысленно. Особенно когда отчислить студента почти невозможно. Мотивированные студенты смотрят на весь этот балаган и в итоге тоже начинают забивать — их усилий никто не оценит.
Плагиат и ГДЗ
Вот возьмем тот же диплом. Раньше, до ChatGPT, нельзя было написать работу за кого-то другого? Или может, нельзя было скопипастить на 80% дипломы прошлых лет? Ну в конце концов, собрать диплом из нескольких готовых статей из интернета? Да, теперь студент это может сделать несколькими промптами бесплатно и с меньшим вовлечением мозгов, но с точки зрения конечных результатов мало что поменялось.
Какие-то контрольные мне и раньше сдавали, списывая статью из Википедии, даже не вникая в суть текста, и без понимания, является ли он ответом. Неоднократно были ситуации, когда списывали из 2 источников и текст ответа противоречил сам себе. И раньше многие математические примеры можно было скормить какому-нибудь WolframAlpha и получить относительно приемлемый ответ. Наконец, никто не отменял старшие курсы с их материалами — если программа и задания особо не меняются, то и готовые ответы будут почти на все.
Короче, и без нейронок будет миллион способов списать/сдать “на отвали”.
Актуальность программы и состава курсов
Чтобы “бороться” с переносом ответов между курсами, надо бы обновлять программу курса регулярно. Признаюсь, что уже на третий год мотивация это делать у меня, как у препода, была близка к нулю: программа семинаров после второго года менялась очень точечно (в последние года — в основном в сторону упрощения), а новые задачи я придумывал максимум по 2-3 штуки за год.
Ну а если пришел студент за одними знаниями, а получает в итоге другие — кто виноват и что делать? Зачастую программа специальности прибита гвоздями и будешь ты на технической специальности учиться рандомным фактам из истории, которые ужали в один семестр с зачетом, потому что “ну надо”. См. раздел про мотивацию.
Помогут ли как-нибудь нейронки актуализировать программы курсов? Теоретически да, но если задания генерит нейронка, то она же их и решать будет. С точки зрения подачи теоретических знаний не так уж часто что-то кардинально меняется. Можно обновить язык и попытаться попасть в текущие тренды, но это скорее мишура (и, вероятнее всего, будет кринжово).
Бороться с бюрократической шизой изменения программ специальностей я бы на месте уважающего себя ИИ не стал бы.
Формальные требования — формальный результат
Когда к диплому предъявляются требования в формате N страниц по структуре X, то и на выходе будет нужное количество страниц с водой, которые даже научный руководитель читать будет наискосок, и то в лучшем случае. И раньше там была сплошная копипаста с графоманией. Если есть пункт только для галочки, так и пусть его нейронка пишет (но надо хотя бы прочитать, чтобы откровенной ерунды не было). Могу сказать, что вода, написанная нейронкой и вода, скопипащенная студентом, практически не отличаются по качеству.
Вообще, если диплом читает в лучшем случае только научник, да и то не весь, почему кто-то так борется за качество текста в нем?
Вас много, я — одна
В идеале экзаменатор должен проверять степень усвоения знаний. Вот только как это сделать нормально?
Письменный экзамен с запретами? Десятки лет эволюции шпаргалок, устройства любого уровня компактности, тупая зубрежка, слитые вопросы и прочие смеются вам в лицо.
Персональные задания? Кто их будет генерить? Нейронка или тупой скрипт, где будут меняться циферки в шаблоне? Ок, задания будут не идентичны, и полные тупни их не вывезут, но существенно они вряд ли что-то поменяют.
Опрашивать каждого студента лично на экзамене и контрольных, чтобы понять его подходы к мышлению и глубину знаний? Вот это хороший вариант. Одна проблема — никак не масштабируется, когда у тебя на 1 лектора и 1 семинариста 100 человек на потоке, и ты хочешь не за красивые глаза оценки ставить. Да и студентам сдавать несколько экзаменов за сессию тяжело уже.
Можно еще давать NP-полные задачи, которые было бы тяжело решить, а проверить можно было бы быстро. Но генерировать интересные задачи в достаточных объемах весьма нетривиально.
Можно ли пользоваться X?
При оценке знаний, например на экзамене, можно ли пользоваться конспектом лекций? Учебником? Калькулятором? Шпаргалками? Интернетом? WolframAlpha? Питоном? ChatGPT?
Где та грань между знаниями, которые должны отлетать от зубов, и информацией, всегда доступной по запросу? Должен ли я помнить факт N? Ничего, что работаю я за компом, где все эти знания есть, а на крайний случай есть телефон?
Стоит ли тратить время на неуспевающих?
Без обратной связи любая система гниет. Если единственный способ у препода избавиться от студента — поставить ему положительную оценку, то корреляция оценки с уровнем знаний будет слабая.
Еще моя бабушка решала вопрос кардинально — ставила всем тройки на халяву: ей было жаль своего времени. Я был не согласен с ее подходом. Из года в год на моем предмете было больше трети недопущенных к экзамену в конце семестра. При этом планка требований падала ниже и ниже.
С точки зрения препода принимать задолженности у двоечников — очень демотивирующее занятие. Эта проблема элементарно решается организационными методами (например, давать только 2 попытки допуститься/сдать). Можно, конечно, решить нейронкой — препод генерит нейронкой задачу, студент нейронкой ее решает, все довольны:)
Нужны ли лекторы?
Ведь можно все что надо найти в интернете (ладно, можно не искать, сейчас все нейронка выдаст) и прочитать, да?
Удачи с поиском в мертвом интернете, да еще ровно в том объеме и ровно с нужного ракурса, чтобы усвоить материал по предмету в рамках нужной специальности.
Гугл сейчас дает “умные ответы от ИИ” на почти любой запрос — как вам, нравится?:)
Когда я учился, то вопрос полезности лекций и, в частности, качества донесения материала, тоже постоянно обсуждался. Правда, тогда учебник все еще использовался как дополнительный аргумент. Однако, однажды перед сдачей экзамена пришлось править статью в Википедии, потому что формула там была неправильная. А еще я был на очной лекции курсов повышения квалификации преподавателей, где нам дедок-лектор рассказывал про неэффективность очных лекций для передачи знаний.
Можно конечно посмотреть рандомного лектора на ютубе, вероятно индуса. Изменят ли тут нейронки что-нибудь? Ну окей, будет тебе трап-аниме-вайфу кавайным голосом рассказывать про символ Лежандра, может это улучшит усвоение материала на пару процентов в абстрактных попугаях, но не более того. А будет ли это стоить потраченной энергии?
И так далее
А еще есть бюрократия, мотивация преподов, миллион дополнительных обходных путей вроде сдачи зачета “нужному” преподу, вопрос “а нужно ли высшее образование вообще”, баланс практики с фундаментальными знаниями и т.п. Продолжать список проблем можно до бесконечности. В этом посте я накидал крупными мазками основное, чтобы проиллюстрировать мысль, но это только верхушка айсберга. Сейчас хорошим преподам приходится искать компромисс среди всего вороха проблем, чтобы хоть какой-то положительный след в умах учеников оставить. Диплом — это уже практически справка о том, что ты не дебил.
Эксперимент с режимом обучения в ChatGPT
Ладно, может, тогда нейронки могут заменить преподов и вузы? Вон, целую школу открыли для 4-5 классов, почти без людей, AI-driven!
А сравнительно недавно (3 месяца назад) ChatGPT представил режим обучения. Вводишь запрос, и нейронка сама тебе подберет программу обучения. Твой личный препод, полная персонализация, кожаные мешки больше не нужны! Вот только после релиза особо новостей про него что-то больше и не видел.
Решил попробовать — попросил ChatGPT рассказать, что такое О-большое в этом режиме. И, как ожидалось, это полная шляпа.
Знания выдавались очень поверхностные, какой-то сложности (кек) или глубины в них не было. Уровень рандомного видоса на ютубе. При этом не были даже упомянуты модели вычислений, элементарные операции, худшие/лучшие случаи, оценки памяти и т.п. Статья из Википедии даст больше контекста, да и страничка из учебника — тоже.
Адекватных проверочных заданий бот не дал, пока я явно не попросил. В итоге я получил… тест с вариантами ответа! Первый вопрос был уровня “Не в Москве ли находится Московский кремль?” Второй вопрос был примерно того же уровня, но вдобавок еще и был не совсем некорректно сформулирован. После третьего вопроса для даунов, бот предложил мне рассказать побольше про O(n log n). Я согласился, и тут мы резко перешли от “оцени сложность цикла” до объяснения, почему сложность сортировки слиянием — O(n log n).
Иллюстративный код был написан на питоне, в котором было копирование слайсов (что на асимптотическую сложность не влияет, но влияет на расход памяти и на реальное время исполнения). Я решил воспользоваться этим и попробовал загазлайтить нейронку, что сложность у этой паршивой реализации будет другой. ChatGPT в ответ каждый раз выдавал простыню текста и постоянно предлагал мне нарисовать картинку, но я игнорил его и настаивал на своем. Еще он пытался слезть с реального кода и вернуться к теории. В итоге я преуспел: мне удалось убедить его, что сложность сортировки слиянием это O(n² log n):
Реально в Python: c_copy(n) и c_merge(n) растут с n, поэтому наблюдаемое время работы может выглядеть как O(n² log n) или даже хуже, особенно при больших объектах или сложных типах.
“You’re absolutely right!” Уже на этом можно было эксперимент закончить. В моей практике неоднократно были ситуации, когда какой-нибудь студент был ну ооочень уверен в своей правоте. Я думаю, что текущие нейронки подобные кадры задушили бы с легкостью. Напоминает истории про то, как люди использовали ChatGPT как психолога/партнера и в итоге отъезжали в психушку/мир иной.
Под конец я добил бота парочкой каверзных блиц-вопросов из своих материалов. В целом бот справился, но у него была глубина ответа среднего студента, а не преподавателя или специалиста. С учетом того, что он генерирует простыни на простейшие запросы, мог бы и получше ответить.
Как все-таки использовать?
Получается, что нейронки для обучения в целом бесполезны? Нет, нужно просто использовать их с умом.
Я надеюсь, что каждый адекватный человек уже задался вопросом — если мои задачи может делать нейронка (при текущем уровне развития), то нафига я нужен? Разумеется, нейронку стоит использовать как инструмент, а не замену себе. Многим нравится еще аналогия, что они руководители, а нейронка — линейный сотрудник.
Но в таком случае, надо знать ограничения и понимать, когда нейронка генерирует дичь. Для этого надо обладать какими-никакими фундаментальными знаниями в области (в том числе, чтобы правильно сформулировать запрос) и уметь перепроверять выплюнутый результат.
Из этого вытекает учебное задание — попросить нейронку что-то сделать, проверить ее результат и перечислить ошибки/недочеты. Давным-давно такое еще на собесах использовали — найди ошибки в кусочке кода — позволяет неплохо оценить глубину знаний.
Причем идея проверки за нейронкой вовсе не нова. Есть история с реддита, и в МГУ есть положительный опыт подобного использования. Из очевидных плюсов — демистифицирует могущество ИИ и позволяет наработать практический опыт: для чего подходит, для чего не очень.
Итого
Еще в январе 2021, за год до первого релиза ChatGPT, я подготовил письмо о своем увольнении из вуза. Его я так в итоге и не отправил (проработал еще 3 года), но часть тезисов из него попали сюда. Основная идея была в том, что текущая система имеет недостатки, я устал и я в ней лишний. Без всяких нейронок.
Еще раньше, в январе 2020, преподаватели кафедры бурно обсуждали проблемы текущей системы. Многие проблемы, судя по мемчикам, за 5 лет особо не изменились (некоторые усугубились).
В общем, на мой взгляд, образование у нас уже давно катится в известное место. Проблемы связаны и усиливают друг друга. И это еще в моем вузе не такая страшная ситуация (хотя объективно есть места, где все же лучше и, можно сказать, не так уж и плохо). Нейронки могут добавить немного скорости к этому движению, но кардинально ситуацию они не поменяют. Безусловно, задача образования — адаптироваться к новым реалиям, но сначала нужно решить старые проблемы.
Еще немного Koka
Финальная (надеюсь) часть истории про Koka. Предыдущие части: первая, вторая.
По сути, доделал, что хотел доделать, и поэкспериментировал с чем хотел.
Получил обратную связь
Запостил ссылку на свой проектик, получил небольшой фидбек от одного из разработчиков. Мелочь, но приятно. Многого и не ждал, т.к. номер обсуждения — девять, и это первое обсуждение в категории “покажи свой проект”.
Когда переходил по ссылкам, внезапно узнал, что ссылки на обсуждения на GitHub имеют сквозную нумерацию с тикетами и PR в репозитории организации. Например, эта ссылка на первое обсуждение перенаправляет на первый PR.
Улучшил сборку
Отрефакторил пайплайн сборки — в итоге сам поиск собирается в релиз при публикации нового тега, и уже он используется при сборке сайта. Все обмазано кэшами. Попутно оптимизировал сборку, чтобы было не 60 мегов, а 31. По умолчанию все печально.
Посмотрел на action от разработчика и на разрабатываемый пакетный менеджер — ну, такое, мягко говоря… Остался на своих велосипедах.
Обновил версию языка и библиотеки.
Увы, особо много интересного не было, за исключением возможности использовать _ в лямбдах как в Scala.
Внес вклад в сообщество
Я открыл еще 8 (восемь!) тикетов, 5 пулл-реквестов и одно обсуждение с тупейшим вопросом. Как будто уже на них работаю, кек:) В библиотеки сообщества все быстро приняли, а в основном репозитории пока почти нет реакции.
Навалил фич
В первую очередь сделал префиксный поиск для последнего токена — наконец-то пригодилось ДДП!
Правда, пришлось писать самопальный поиск элементов, следующих за данным.
В стандартной библиотеке толком не используется факт упорядоченности map и никаких методов нет.
Вообще, уже одна эта фича улучшила поиск существенно. Несмотря на искусственное понижение результатов в выдаче, именно с префиксного поиска больше всего полезных результатов выпадает.
Пока вспоминал базу с ДДП, написал первые тесты. Не обошлось без проблем, но поправил сам, и получилось терпимо.
Наконец, написал стеммер. Смысла в нем не очень много, но изначально хотел его сделать и решил все-таки поставить галочку. Сам алгоритм оказался гораздо проще, чем я думал, практически вызов цепочкой однообразных функций с разными параметрами. До самих функций конечно надо додуматься, но на это не ушло много времени.
Уже на стадии чтения описания алгоритма я почти сразу придумал слово, которое будет плохо обработано: “карась” будет урезан до “кар” из-за возвратного “сь”. Поэкспериментировать самостоятельно можно тут, таких примеров можно найти много. Но многого ожидать от бесконтекстных стеммеров не стоит, да мне и не надо.
У стемминга есть нюанс, что он потенциально не очень хорошо сочетается с префиксным поиском для поиска длинных строк, но я не заметил разницы на реальных данных. Но у него есть и безусловный плюс — уменьшение размера индекса почти в 1,5 раза (JSON с индексом теперь 1,1 Мб вместо 1,6 Мб). Ну и точность ранжирования должна быть получше за счет объединения терминов.
Больше времени убил на борьбу со стандартной библиотекой.
Несмотря на то, что там есть проекция (view) строки, нужных мне методов там не оказалось, и доступа к отдельным символам по индексу тоже.
Я сначала честно пытался что-то построить с существующим API, но в итоге признал поражение и написал свою урезанную проекцию из велосипедов и грязных while с нужными мне методами.
Но на этом приколы со стандартной библиотекой не закончились.
Внезапно обнаружилось, что в ней нет flatmap для maybe.
Позже — совсем мрак: нет contains для списка!
Ладно, есть any, но это как вместо isEmpty писать .count > 0 (передаю привет C#).
Наконец, последней фичей стало переключение раскладки — “ns gbljh” чтобы искалось. Реализуется тоже элементарно, главное учесть, что смену раскладки надо сделать до токенизации (иначе всякие бюжъх потеряются), но после приведения к нижнему регистру.
Заключение
В целом, не ожидал, что после первой провальной попытки будет столько мотивации работать над этим проектом. Результатом я весьма доволен, получилось то, что я хотел. И что-то новое по дороге узнал, и со старых навыков сдул пыль. Надеюсь, что после пары минорных правок успокоюсь и переключусь на что-то другое:)